「信頼性の高い大規模言語モデルの説明可能性」に関する論文がNeurocomputing誌に採択されました。
2026-10-05
- article
早矢仕准教授の共著論文「Explainability of large language models: Opportunities and challenges toward generating trustworthy explanations」が、Elsevierの国際学術誌Neurocomputingに採択されました。
タイトル:Explainability of Large Language Models: Opportunities and Challenges toward Generating Trustworthy Explanations
著者:Shahin Atakishiyev, Housam K.B. Babiker, Jiayi Dai, Nawshad Farruque, Teruaki Hayashi, Nafisa Sadaf Hriti, Md Abed Rahman, Iain Smith, Mi-Young Kim, Osmar R. Zaïane, Randy Goebel
掲載誌:Neurocomputing(Elsevier, 2026)
https://www.sciencedirect.com/science/article/abs/pii/S0925231226026792
本研究では、近年注目を集める大規模言語モデルの説明可能性(Explainability)に焦点を当て、その信頼性と有効性を高めるための理論的・実証的枠組みを提案しました。生成AIが医療や自動運転などの社会基盤にも応用される中、「なぜこの出力をしたのか」を理解し、利用者がその判断を信頼できるようにすることが急務となっています。しかし、LLMはその内部構造が複雑で、出力の根拠が不透明になりやすいという課題があります。
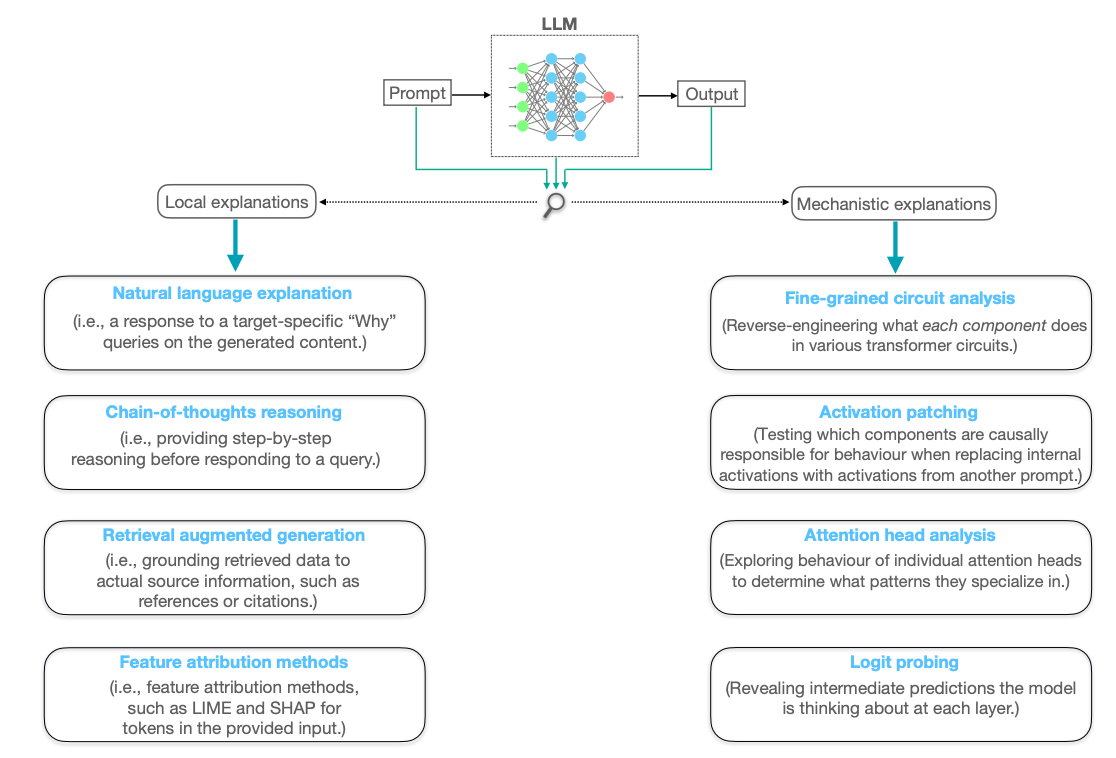
そこで本研究では、局所的な出力理由を明らかにする「ローカルな説明可能性(local explainability)」と、モデル内部の動作原理を解析する「機構的解釈可能性(mechanistic interpretability)」という二つの観点から、LLMの説明生成と信頼形成のあり方を体系的に整理しました。さらに、医療診断支援や自動運転といった高リスク領域を対象に、説明が利用者の理解と信頼に与える影響を分析し、説明の忠実性や明示性が信頼形成に重要であることを論じています。
本論文は、AIシステムの透明性と説明責任を高めるための方法論を提供するとともに、説明可能なAI(XAI)の実装に向けた新たな方向性を提示するものです。今後は、モデル構造の可視化技術や説明評価の標準化を進め、社会的に信頼されるAIの実現に貢献していくことが期待されます。
本研究は、早矢仕准教授がVisiting Professorとしてカナダのアルバータ大学に滞在していた際のXAI Labのメンバーとの共同研究の成果です。プレプリント公開時の紹介記事はこちら。ぜひご一読ください。